Toda equipe que cria agentes de IA descobre uma verdade fundamental: sem as informações certas, um agente não consegue dar uma resposta a uma pergunta ou tomar a ação correta de forma confiável.
À medida que as janelas de contexto dos LLM aumentavam, era tentador presumir que fornecer mais informações a um agente melhoraria sua precisão. Na prática, mais contexto torna os agentes mais lentos e caros, além de reduzir a precisão ao enterrar sinais úteis entre informações irrelevantes.
É por isso que o sucesso de um agente agora depende da engenharia de contexto, a prática de selecionar, organizar e apresentar a um agente apenas as informações necessárias para concluir uma tarefa com eficácia.
E o cerne desse trabalho acontece na recuperação. A questão não é quanto você pode colocar no contexto. São quais dez coisas de dez milhões você escolhe.
A plataforma de dados inteligente do MongoDB reúne os melhores modelos de embedding e reranking da Voyage AI com uma plataforma para criar, operar e evoluir sistemas de recuperação complexos. Com a introdução hoje da série Rerank 3 e do $rerank no pipeline de agregação, os desenvolvedores podem melhorar a qualidade e a ordenação do contexto recuperado no mesmo sistema em que residem seus dados operacionais. O resultado é uma maneira mais simples de criar sistemas de recuperação que dão aos agentes o contexto de que precisam para tomar ação.
A pilha de recuperação
A recuperação eficaz requer um sistema coordenado para encontrar informações úteis, determinar o que é mais importante e entregá-las com eficiência ao agente.
A estratégia determina como o sistema busca seus dados. A busca por palavras-chave pode trazer termos exatos, enquanto a pesquisa vetorial encontra conteúdo conceitualmente semelhante. Os filtro e as abordagens híbridas acrescentam precisão e controle, garantindo que apenas o contexto relevante seja recuperar.
Os modelos determinam como é a relevância dos seus dados. Um modelo de embedding mais forte ajuda a pesquisa vetorial a identificar melhores candidatos ao compreender a semelhança conceitual e a intenção da query. Um reranker permite que a recuperação de primeiro estágio otimize o recall e, em seguida, separa as correspondências mais fortes do conjunto de candidatos.
O mecanismo certo reúne essas tecnologias díspares, mantendo os dados atualizados e as querys eficientes conforme o sistema é executado em produção.
Sem uma plataforma unificada para gerenciar a recuperação, o trabalho fica complicado rapidamente. Você pode usar um provedor para embeddings, outro para reranking e vários fornecedor de banco de dados para seus dados operacionais, de pesquisa e vetoriais. Isso significa mais integrações, tarefas de sincronização e chamadas de API para manter. Também pode criar problemas silenciosos: o índice de pesquisa vetorial pode usar uma versão do modelo de embedding enquanto seu aplicativo usa outra, prejudicando a relevância sem causar um erro explícito.
Figura 1. O pipeline de recuperação desconectado.
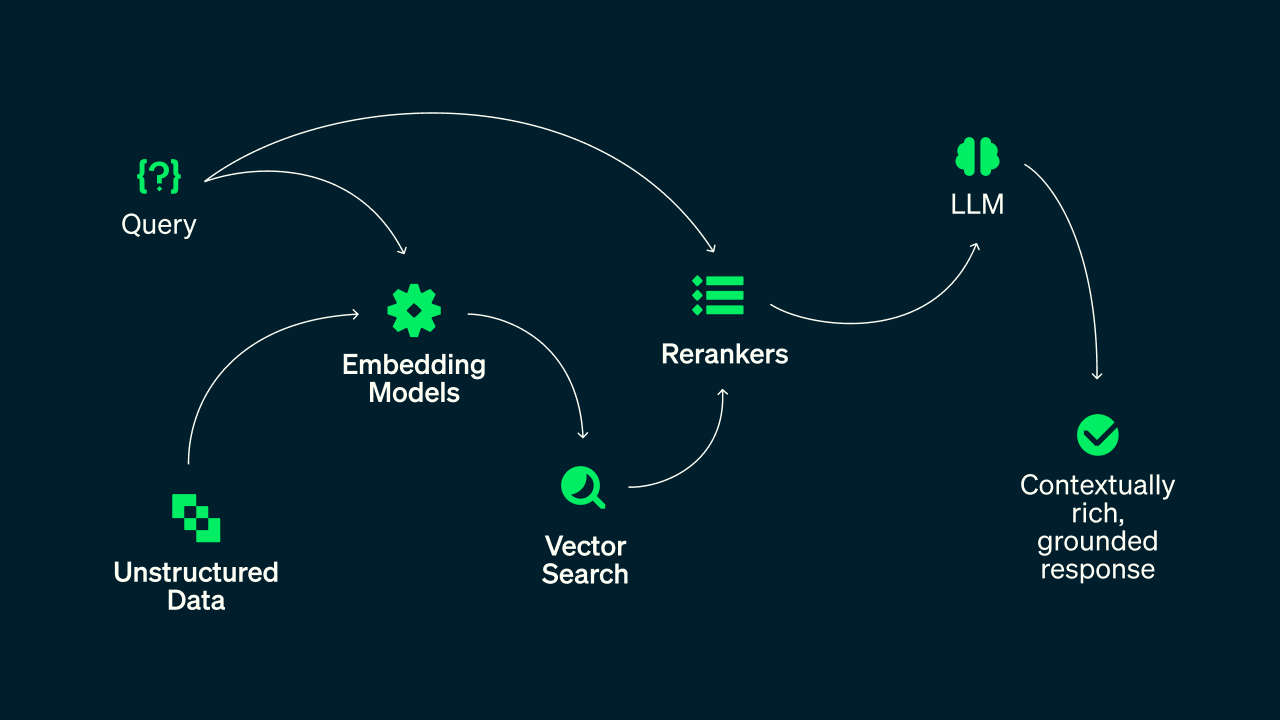
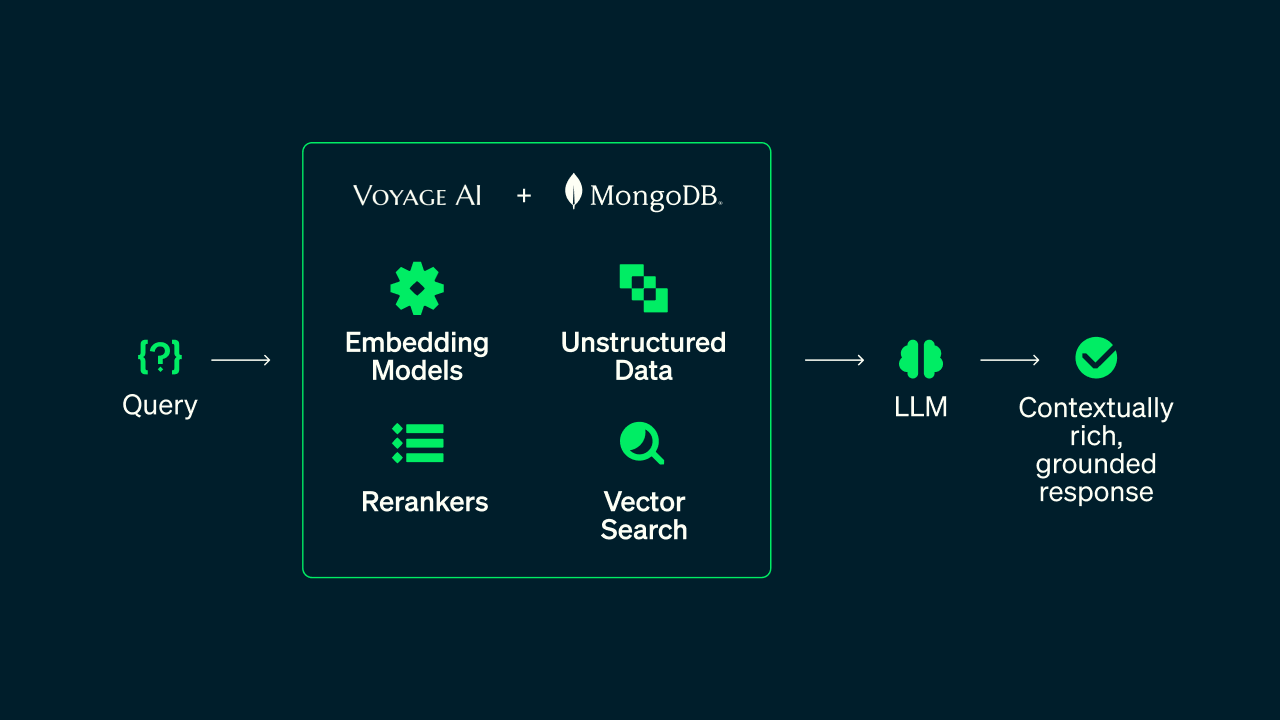
O MongoDB reúne esses elementos em uma única plataforma. Ele oferece suporte às estratégias de pesquisa que os desenvolvedores precisam, incluindo recuperação de texto, vetor, híbrida e com filtro, e as combina com os modelos de embedding e rerankers de última geração da Voyage AI. A embedding automatizado mantém os vetores sincronizados à medida que os dados mudam, enquanto o rerank nativo permite que os desenvolvedores refinem os resultados no mesmo pipeline de agregação. O resultado é uma única query que pode pesquisar dados operacionais, aplicar a estratégia de recuperação certa, reclassificar os resultados e retornar o contexto que um agente precisa.
Figura 2. O pipeline de recuperação unificado impulsionado pelo MongoDB.
Os modelos
A introdução hoje do rerank-3 e rerank-3-lite oferece melhor precisão em todas as tarefas, com os maiores ganhos em documentos longos e código. O rerank-3 supera o Cohere Rerank v4.0 Pro em 2,72% e o Qwen3-Reranker-8B em 3,02% no geral. Se você usa o rerank-2.5 hoje, o upgrade é uma alteração do nome do modelo de uma linha. Mesma API, mesmo preço.
O rerank-3 melhora a relevância, independentemente de como o conjunto inicial de candidatos é recuperado. A tabela abaixo mostra o aumento da precisão em vários métodos comuns de recuperação em primeiro estágio.
Tabela 1. Comparações de precisão.
O mecanismo
O MongoDB é o mecanismo de recuperação operacional por trás de tudo isso, e todas as estratégias são executadas nativamente nos mesmos dados nos quais seu aplicativo já grava. A pesquisa lexical captura identificadores, códigos de erro e nomes exatos de produtos. A pesquisa vetorial captura conceitos e paráfrases. A recuperação híbrida os combina, e os filtros de metadados mantêm o conjunto de candidatos pequeno o suficiente para continuar sendo rápido. Nada disso requer mover os dados para um sistema separado ou manter duas cópias em sincronização.
O Automated Embedding lida com a parte que geralmente quebra. Os vetores são gerados e atualizados no nível do campo em tempo real, com consumo de token e integridade do índice visíveis na IU do Atlas. Não há tarefa de embedding para possuir e nenhuma chance de divisão entre a versão do modelo em que seu índice foi criar e a versão do modelo na qual suas query são executadas.
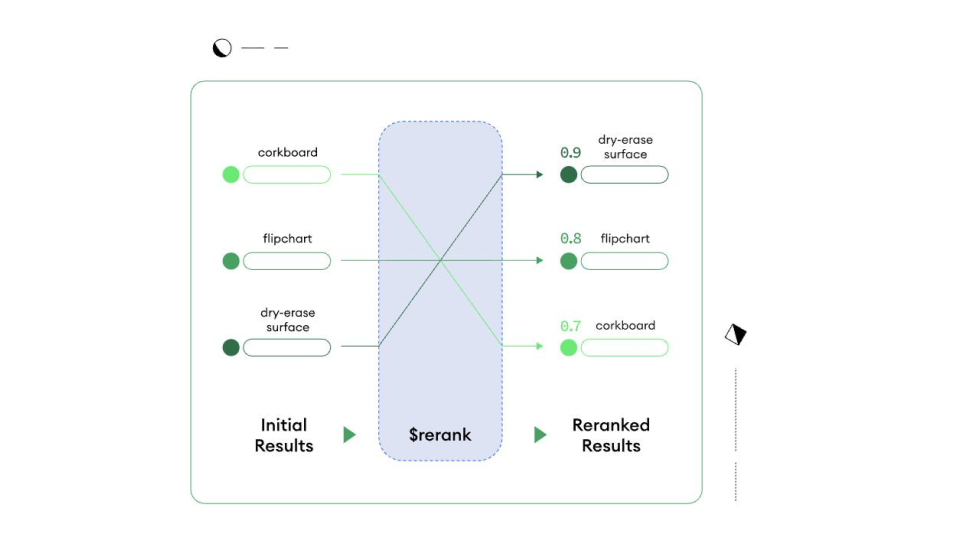
O $rerank, disponível hoje, adiciona a etapa final de ordenação a esse mesmo pipeline. É um estágio sem índice que pode pegar qualquer conjunto de candidatos que o estágio anterior produziu e reclassificá-lo com rerank-3 ou rerank-3-lite. Nenhum fornecedor separado, nenhuma chamada de API externa, nenhuma etapa de remontagem no código da aplicação — o que é importante quando um agente está fazendo várias chamadas de recuperação por tarefa em vez de uma.
Figura 3. $rerank em ação.
Gravity: Veja como funciona
A Gravity está criando uma rede de publicidade que otimiza a publicidade para a era da IA. A relevância não é algo bom para se ter; é o produto. O problema não era a recuperação. Os modelos anteriores de embedding e reranking retornaram pontuações de relevância agrupadas muito próximas umas das outras, então a Gravity não conseguiu separar com confiança uma correspondência forte de uma fraca.
“O ponto mais importante que descobrimos em nossos benchmarks foi a capacidade da Voyage AI de ser discriminatória com candidatos que não são compatíveis e realmente promover os que são”, disse Leo Martinez, cofundador e CTO da Gravity. A mudança para a Voyage AI reduziu a latência de recuperação em cerca de 50% e melhorou a precisão conforme o volume de solicitações aumentava.
Fechando a lacuna
A qualidade da recuperação é uma camada do que o MongoDB está construindo para que os agentes executem. O MongoDB 9.0 e o Atlas Infinite são a camada de desempenho e de dimensionar elasticamente, absorvendo o tráfego intermitente que as cargas de trabalho de agentes criam. O Atlas Agent Engine é a camada de memória e governança, dando aos agentes contexto persistente e guardrails entre sessões; a recuperação é alimentada pelo Atlas Vector Search e Voyage AI. Um agente decide o que recuperar antes de decidir o que fazer. Infraestrutura mais rápida com recuperação ruim só significa agir sobre a coisa errada mais cedo.
Obter a recuperação certa não requer mais uma arquitetura complexa. A Embedding automatizado lida com os embeddings, o $rerank lida com o ordenamento e ambos são executados em seus dados operacionais diretamente no MongoDB. Os modelos também estão disponíveis autônomo por meio da Embedding and Reranking API do Atlas.