生成 AI アプリケーションのコンテキストで「AI エージェント」という期間が使用される際には、大規模言語モデル(LLM)が最初から最後まで複雑なタスクを自律的に実行するシステムを想像しがちです。しかし、ほとんどの現実世界のアプリケーションでは、完全な、チェックされていない LLM の自律性は必要ありません。Andrew Ng 氏のこのツイートには本当に共感しました。特に、次の部分は印象的でした。
「あるものがエージェントであるかどうかをバイナリ形式で選択するのではなく、システムを程度の差はあれエージェント的だと考える方が有用だと思いました。」
自律性に対してより全体的なアプローチを取り、LLM への単純なプロンプトと完全に自律的な AI エージェントの中間に位置するシステムも網羅するために、「エージェント型システム」という用語を使用する方が役立ちます。
したがって、エージェント型システムとは、LLM を使用して、さまざまな程度の自律性を持つアプリケーションの実行フローを決定するシステムであると定義します。これには、LLM が構造化されたワークフロー内で限定的な決定を行う実装から、人間による介入を最小限に抑えて LLM がタスクを独立して実行する実装までが含まれます。「エージェント性」の程度は、LLM に委任される意思決定権限の大きさによって定義されます。
この記事では、当社がお客様とともに実装した、エージェント型システムのための実践的な設計パターンを 7 つ紹介します。各パターンについて、その仕組み、使用するタイミング、具体的なユースケースを見ていきます。
目次
制御されたフロー
制御されたフローは、LLMをワークフローに統合するための低リスクな方法です。この設計パターンでは、LLMはワークフローの各ステップ内でコンテンツ生成や分析などのタスクを積極的に実行しますが、ステップの順序とステップ間を移動するためのルールは設計上固定されています。つまり、LLMは各ステップ内で自由に動作できますが、プロセス内で次にどのステップに進むかを選択することはできません。
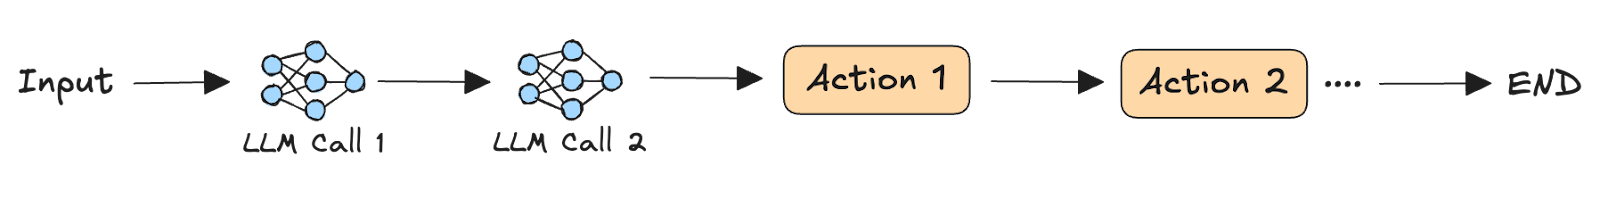
注意: このブログ全体を通して、任意の図にある複数の LLM 呼び出しは、異なるプロンプトを使用した単一の LLM への呼び出し、または異なる LLM への呼び出しを表す場合があります。
使用するタイミング
このパターンは、タスクを明確に定義された一連のサブタスクに分解でき、その一部をLLMで確実に処理できるシナリオに最適です。ここでの主な目的は、LLMを使用しているにもかかわらず、信頼できる結果や決定論的な結果を生成するシステムの能力を保持することです。
使用例
コンテンツレビュー:LLM を使用してコンテンツレビューを部分的に自動化し、句読点や文法エラーを修正し、スタイルガイドと照らしてコンテンツを検証し、事実確認を行った後、ドキュメントを人間による技術レビューに転送します。
自然言語からクエリへ:LLM を逐次的な自己クエリワークフローの一部として使用し、データソースやクエリフィルターなどのクエリパラメーターを識別して最終的な回答を合成します。
ルーターとしての LLM
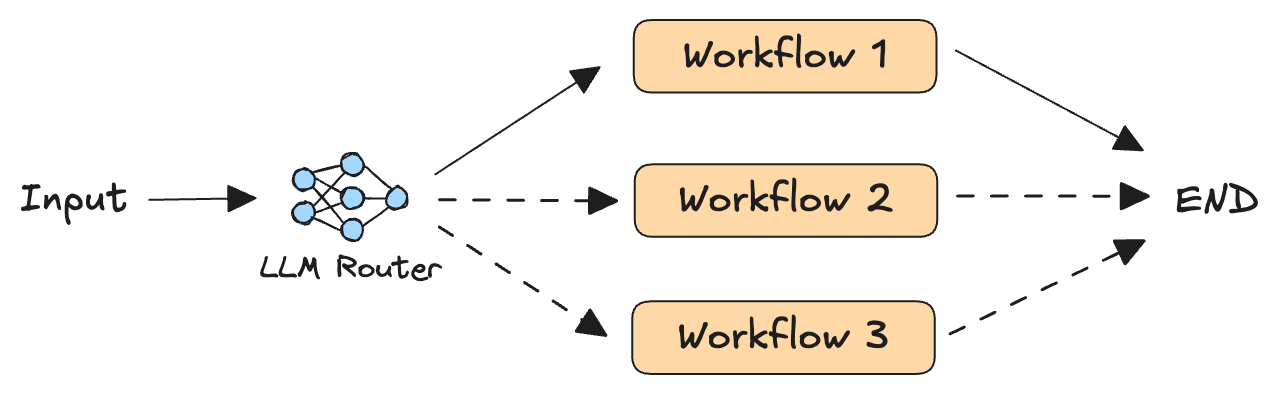
この設計パターンでは、クエリは、LLM の入力の分類に基づいて、設定された数の専門的なワークフロー間でルーティングされます。これは、着信情報を監視し、「次にどこへ送るべきか」を決定するスマートスイッチと考えることができます。これらの専門的なワークフローには、プロンプトが異なる同じ LLM、小規模 LLM と大規模 LLM の組み合わせ、ドメイン固有の微調整されたモデル、またはマイクロサービスと API が含まれる場合があります。
使用するタイミング
このパターンは、受信リクエストがさまざまなトピックや複雑さのレベルにまたがる場合でも、内容に基づいて確実に分類できる場合に適しています。主な目的は、アプリケーションの入力が幅広い場合でも、正確な応答を確保することです。
使用例
カスタマーサービス:リクエストの性質に基づいて、カスタマーサービスのリクエストを異なる部門の下流のプロセスにルーティングします。
リソース効率の良いルーティング:単純な質問をより小さく安価な LLM にルーティングし、複雑な質問を推論モデルにルーティングします。
並列化
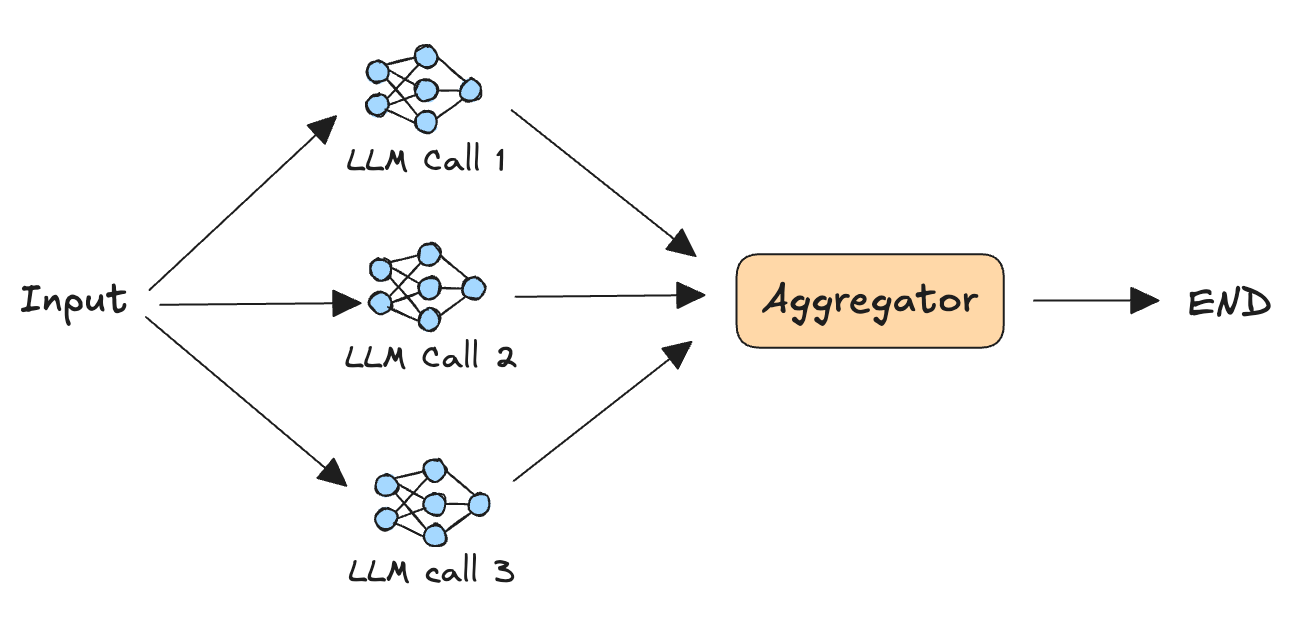
この設計パターンでは、複数の LLM が同じタスクまたは複雑なタスクのサブタスクに同時に取り組み、その出力は別の LLM またはカスタムロジックによって集約されます。
使用するタイミング
このパターンは、独立したサブタスクに分割できるタスクを処理する場合に役立ちます。これらのサブタスクを並列で実行すると、全体的なレイテンシの短縮と、各 LLM が問題の特定の部分の解決に集中できることによる集中力の向上という、主に2つのメリットがあります。場合によっては、複数の LLM に同じタスクを試行させ、その結果を比較または組み合わせることで、信頼性を向上させることもできます。
使用例
判断者としての LLM:LLM の応答を評価する一般的な手法は、強力な LLM 自体を使用することです。並列化デザインパターンを使用すると、複数の LLM、または異なるプロンプトを持つ単一の LLM が、応答のさまざまな側面を同時に評価できます。
コード生成:プロンプトが与えられたら、さまざまな LLM を使用してコードを生成します。次に、各コードスニペットを実行し、LLM を使用してその効率を分析し、最も効率的なものを返します。
振り返りと批評
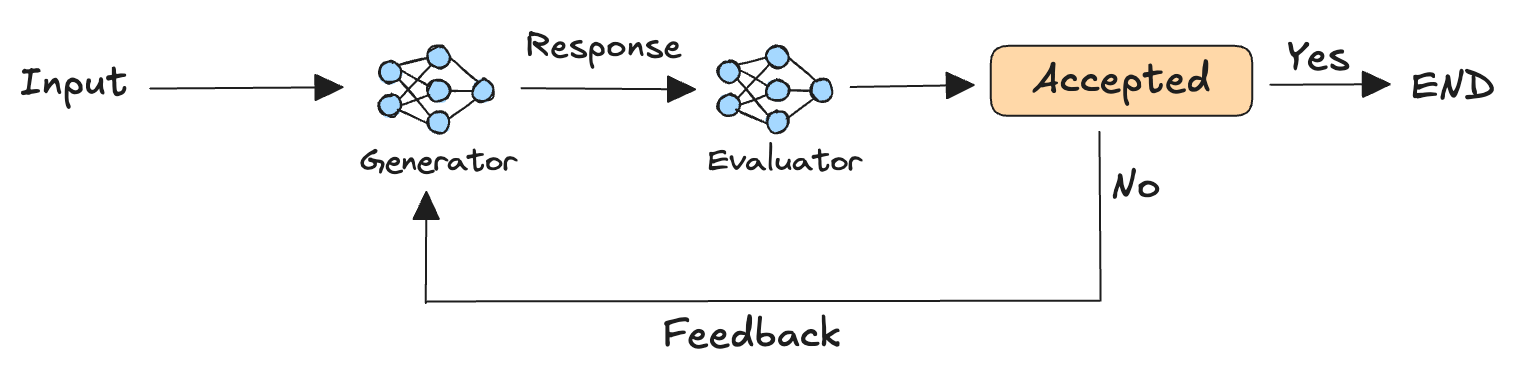
この設計パターンでは、1つ目の LLM(ジェネレーター)が応答を生成し、2つ目の LLM(エバリュエーター)がそれを振り返って批評またはフィードバックを提供します。このプロセスは、エバリュエーターが応答を受け入れ可能であると判断するまでループで続きます。
使用するタイミング
このパターンは、人間のようなフィードバックに基づいてLLMの応答を反復的に改善することで、より正確で信頼性が高く、一貫性のある結果を得られるタスクに効果的です。LLMは評価者として使用されるため、LLMが評価基準を効果的に推論し、人間のようなフィードバックを提供できるように、評価基準を明確に定義する必要があります。
使用例
レポートの生成:エバリュエーター LLM に生成されたレポートがスタイルガイドに準拠しているか、特定の詳細、図、分析が含まれているかを確認させ、改善に向けた推奨事項を提示させます。
コードの改良:プロンプトが与えられると、ジェネレーター LLM がコードを書き込み、エバリュエーター LLM がコードレビュアーとして機能し、コードを最適化する方法を提案します。
ヒューマン・イン・ザ・ループ
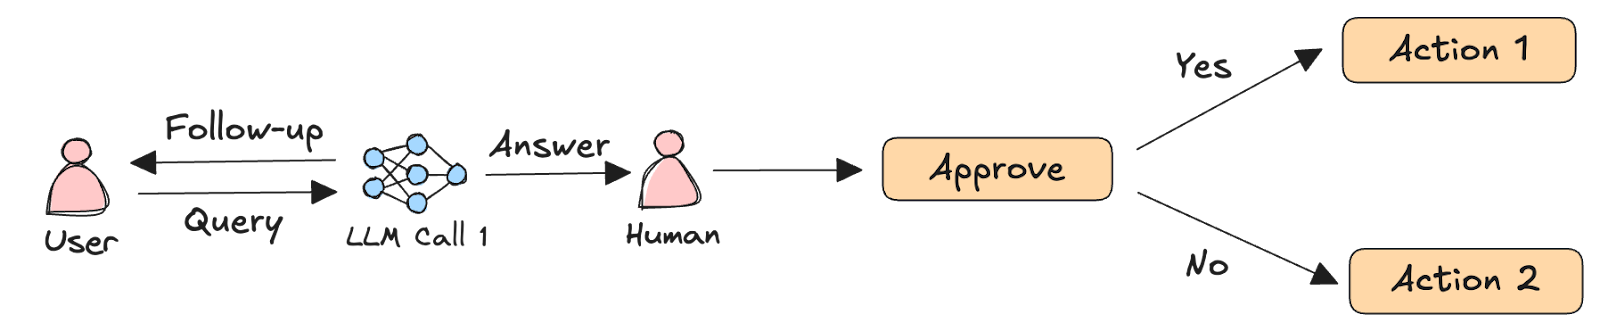
この設計パターンは、人間による入力を、自動化された LLM ベースのパイプラインに組み込みます。これにより、LLM は対話中に説明や詳細を求めることができますが、同時に人間がパイプラインの重要なポイントで LLM の出力をレビュー、検証、編集、または上書きすることもできます。これにより、特に機密性の高いタスクにおいて、アプリケーションの信頼性が大幅に向上します。
使用するタイミング
このパターンは、システムの基本要件により完全な LLM ベースのオートメーションが実現不可能な場合や、不適切な結果がもたらす可能性のある影響により望ましくない場合に特に役立ちます。しかし、自然言語は曖昧になりうるため、説明やフォローアップのための人間の入力は、すべての LLM ベースのワークフローに利益をもたらします。
使用例
コンピュータの使用:この手法では、LLM を使用して Web ベースのタスクを自動化しますが、特定の認証手順(ログイン、2FA、CAPTCHA)は本質的に人間の介入を必要とするため、自動化することはできません。
健康保険の請求処理:LLMを使用して請求を分析し、承認または却下の推奨に関する詳細な根拠を提示します。ただし、人間の査定担当者は、分析をレビューした後に最終判断を下します。
エージェント
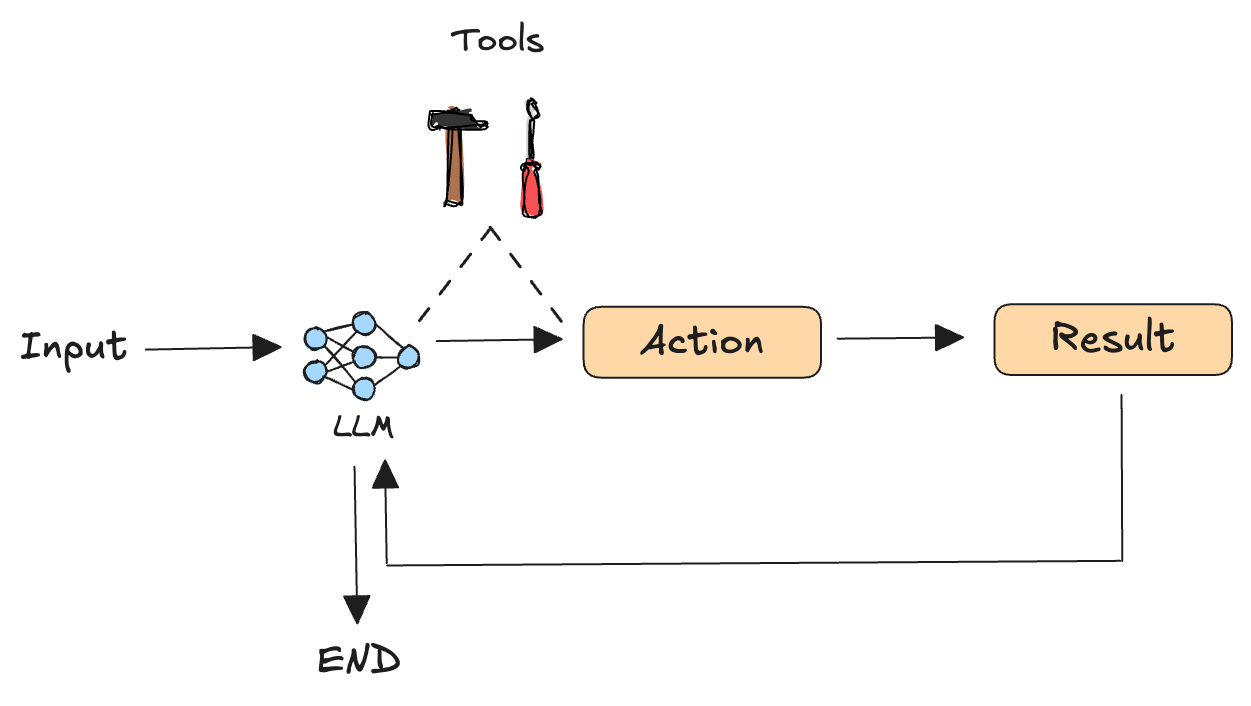
人々は通常この設計パターンを「AI エージェント」と呼びます。エージェントと前述の設計パターンの主な違いは、エージェントは LLM を使用して、特定のタスクを完了するために必要な一連のステップを決定することです。エージェントは、ツールの助けを借りてアクションを実行し、以前のアクションの結果を推論して次のアクションを決定することで、これを行います。これにより、エージェントは、適切なツールにアクセスできる限り、非常に柔軟で、幅広い複雑なタスクを処理できるようになります。
以下の図は、ツールにアクセスできる1つの LLM だけで構成されるシングルエージェントアーキテクチャを示しています。
使用するタイミング
AI エージェントは、必ずしも構造化されたワークフローを必要とせず、レイテンシの許容度が高く、非決定的な出力が許容されるタスクに最適です。
使用例
適応型学習:エージェントを使用して、学生の学習パターンとパフォーマンスを分析し、重点を置くトピックを決定し、難易度を調整します。
ソフトウェアアプリの構築:プロンプトが与えられると、エージェントはコードを反復的に生成、テスト、デバッグ、改良して、フロントエンド、バックエンド、データベース統合、認証を含む、完全に機能するソフトウェアアプリを作成できます。
注:ヒューマン・イン・ザ・ループや振り返りと批評など、他の設計パターンの一部の要素をAI エージェントと組み合わせることで、AI エージェントの信頼性を高めることができます。
マルチエージェント
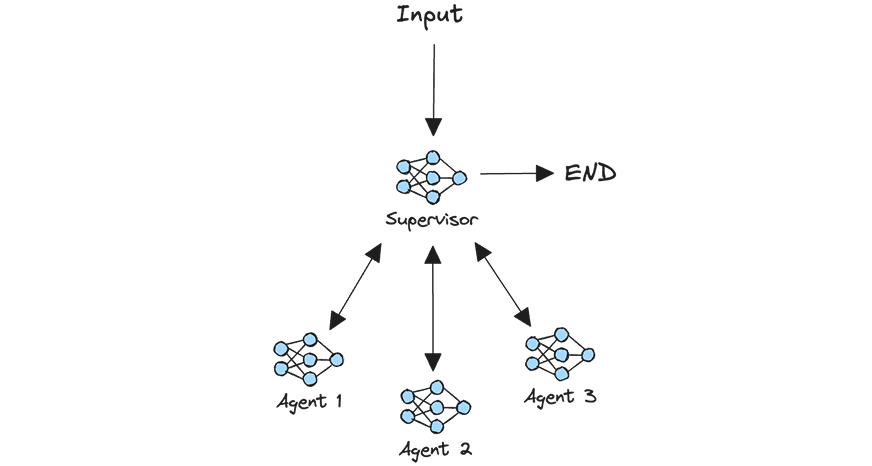
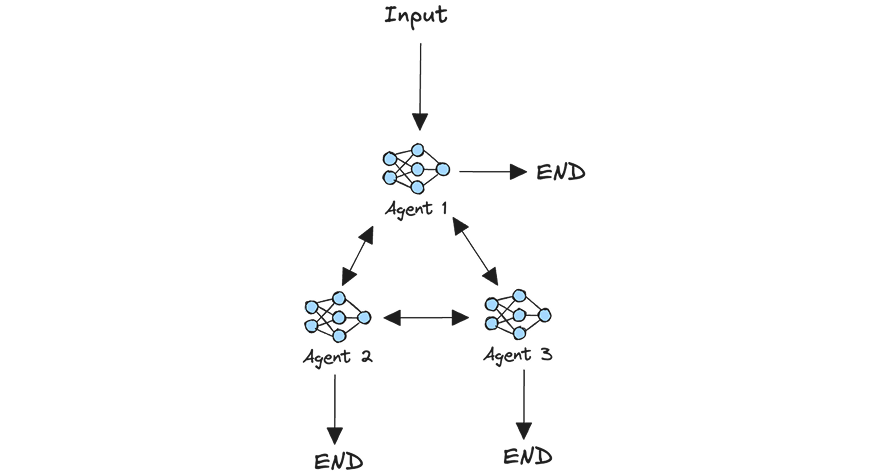
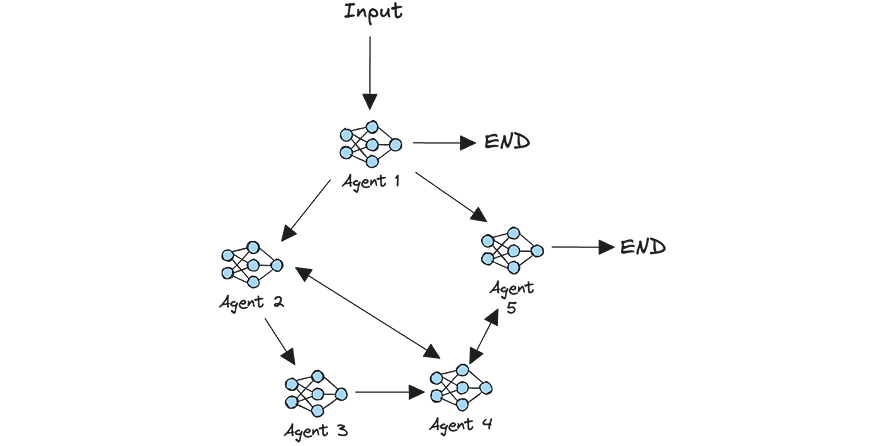
この設計パターンは AI エージェントの究極の進化形であり、複数のエージェントが連携して複雑なタスクを達成します。アプリケーションのニーズに応じて、これらのシステムを設計する方法はいくつかあります。
スーパーバイザー:単一のエージェント(スーパーバイザー)がエージェントのグループと連携して、次のアクションを決定します。
ネットワーク:各エージェントは他のすべてのエージェントと通信し、次にどれを呼び出すか、または実行を終了するかを決定できます。
カスタム:このカスタム設定では、どのエージェントが相互に交流できるか、それらの間で制御がどのように流れるかを決定します。
使用するタイミング
マルチエージェントアーキテクチャは LLM の自律性の限界を押し広げ、予測が困難なオープンエンド、斬新、または実験的なタスクを探索できます。実用的で現実世界のユースケースでは、より単純な設計パターンから始めます。必要であれば、予測不可能な結果が許容されるタスクに対してのみ、マルチエージェントアーキテクチャを使用します。完全に自律的なマルチエージェントワークフローは、コストとレイテンシの増大を意味し、デバッグが困難なシステムになる可能性があるため、慎重に使用してください。
使用例
科学的発見:AI エージェントのチームが連携して、複雑なドメインで新しい仮説を生成しテストします。その際、異なるエージェントが文献レビュー、実験設計、テスト、検証を専門に行います。
マルチメディアのストーリーテリング:さまざまな芸術的専門性を持つ AI エージェントが協力して、動的なストーリーライン、キャラクター、ビジュアル、音楽スコアを作成し、新しい形式のインタラクティブまたは生成的なストーリーテリングを模索します。
結論
この記事では、厳密に制御されたシステムから、LLM で可能なことの境界を押し広げる高度に自律的なシステムまで、7つのエージェント型設計パターンを取り上げました。新しい設計パターンは毎週登場していますが、常に最新のイノベーションを追いかけることが最善の戦略であるとは限りません。代わりに、特定のニーズと技術的要件に焦点を当てます。機能する最も単純なアーキテクチャから始めて、そのパフォーマンスを慎重に評価し、明らかに必要であるという明確な証拠がある場合にのみ、追加のコンポーネントを追加します。
AI エージェントの構築は初めてですか?まずは当社の AI ラーニングハブと生成系 AI ショーケース GitHub リポジトリにアクセスして、豊富なコンテンツや使用例をご確認ください。
どのようなエージェント型設計パターンが効果的でしたか?生成系 AI コミュニティフォーラムで共有しましょう。